
本文章主要介绍redis选用的数据结构和对应的实现方式
1.简单动态字符串(simple dynamic string,SDS)
当Redis需要的不仅仅是一个字符串字面量,而是一个可以被修改的字符串值时,Redis就会使用SDS来表示字符串值,比如在Redis的数 据库里面,包含字符串值的键值对在底层都是由SDS实现的。
1.1SDS基础定义
我们来看看redis对sds的定义:
struct sdshdr {
// 记录buf 数组中已使用字节的数量
// 等于SDS 所保存字符串的长度
int len;
// 记录buf 数组中未使用字节的数量
int free;
// 字节数组,用于保存字符串
char buf[]; };
来看一个实例:
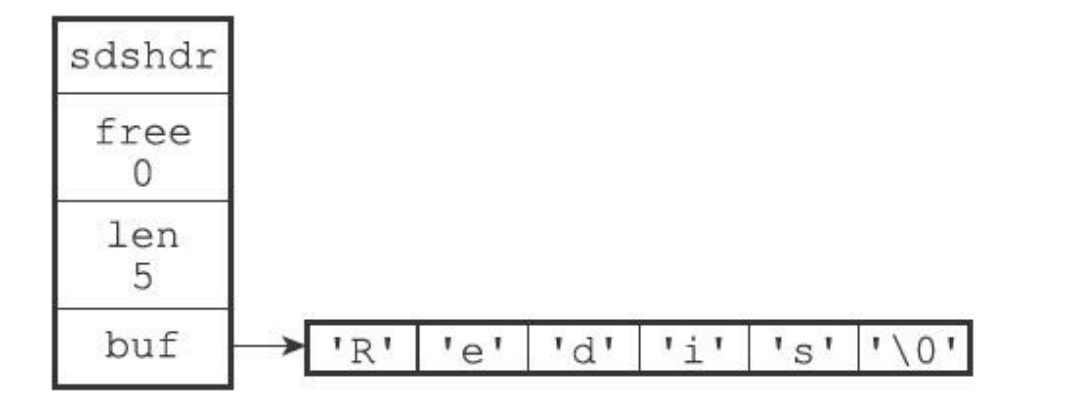
其中free为零代表sds没有未分配的空间,
len表示sds保存了一个五字节的字符串,
buf表存贮的字符数组。
注意:字符数组最后保存了'\0',且最后的空字符不计入len的计数,这遵循C字符串以空字符结尾的惯例,这样可以直接重用一部分C字符串函数库里面的函数。
1.2 sds与c字符出的区别
1.2.1常数复杂度获取字符串长度(len属性)
对于c实现的字符串并没有设置一个属性来获取字符串的长度,获取字符串的长度需遍历整个字符串,所以时间复杂度是O(N)。
而sds专门定义了len属性来获取字符串长度,所以获取字符串长度复杂度是O(1)。设置和更新SDS长度的工作是由SDS的API在执行时自动完成的, 使用SDS无须进行任何手动修改长度的工作。
这确保了获取字符串长度的工作不会成为Redis的性能瓶颈。例如,因为字符串键在底层使用SDS来实现,所以 即使我们对一个非常长的字符串键反复执行STRLEN命令,也不会对系 统性能造成任何影响,因为STRLEN命令的复杂度仅为O(1)。
1.2.2解决缓存溢出(len属性)
对于c字符串因为不记录字符串的长度,当我们在进行字符串拼接的时候是有可能导致缓存溢出的。
举例:现在有两个内存紧邻的C字符串s1和s2,其中s1保存了字符串"Redis",而s2则保存了字符串"MongoDB"
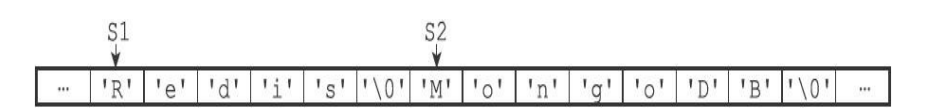
如果这个时候要将s1的字符串内容改为“Redis Cluster”,而s1没有分配足够的内存空间就会导致,s1多出来的字符串内容将s2的内容覆盖。
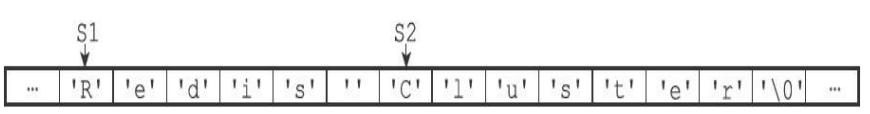
对于SDS的空间分配策略完全杜绝了发生缓冲区溢出 的可能性:当SDS API需要对SDS进行修改时,API会先检查SDS的空间 是否满足修改所需的要求,如果不满足的话,API会自动将SDS的空间 扩展至执行修改所需的大小,然后才执行实际的修改操作,所以使用 SDS既不需要手动修改SDS的空间大小,也不会出现前面所说的缓冲区溢出问题。
1.2.3减少修改字符串时带来的内存重分配次数(free属性)
对于c字符串底层实现总是一 个N+1个字符长的数组,每次增 长或者缩短一个C字符串,程序都总要对保存这个C字符串的数组进行 一次内存重分配操作。
SDS通过未使用空间解除了字符串 长度和底层数组长度之间的关联:在SDS中,buf数组的长度不一定就是字符数量加一,数组里面可以包含未使用的字节,而这些字节的数量就 由SDS的free属性记录。
通过未使用空间,SDS实现了空间预分配和惰性空间释放两种优化策略。
1.空间预分配
空间预分配用于优化SDS的字符串增长操作:当SDS的API对一个 SDS进行修改,并且需要对SDS进行空间扩展的时候,程序不仅会为 SDS分配修改所必须要的空间,还会为SDS分配额外的未使用空间。
额外空间分配公式:
    if(len < 1Mb):
    //分配和len空间大小一样的额外空间
        free = len;
    else if (len >= 1Mb):
        //分配额外的1Mb的额外空间
free = 1Mb;通过空间预分配策略,Redis可以减少连续执行字符串增长操作所需的内存重分配次数,SDS将连续增长N次字符串所需的内存重分配次数从必定N次降低为最多N次。
2.惰性空间释放
惰性空间释放用于优化SDS的字符串缩短操作:当SDS的API需要 缩短SDS保存的字符串时,程序并不立即使用内存重分配来回收缩短后多出来的字节,而是使用free属性将这些字节的数量记录起来,并等待将来使用。
1.2.4二进制安全
C字符串中的字符必须符合某种编码(比如ASCII),并且除了字 符串的末尾之外,字符串里面不能包含空字符,否则最先被程序读入的 空字符将被误认为是字符串结尾,这些限制使得C字符串只能保存文本 数据,而不能保存像图片、音频、视频、压缩文件这样的二进制数据。
redis为了适应不同使用场景,SDS的API都是二进制安全的(binary-safe),所有SDS API都会 以处理二进制的方式来处理SDS存放在buf数组里的数据,程序不会对其 中的数据做任何限制、过滤、或者假设,数据在写入时是什么样的,它被读取时就是什么样。
这也是我们将SDS的buf属性称为字节数组的原因——Redis不是用 这个数组来保存字符,而是用它来保存一系列二进制数据。
1.2.5兼容部分C字符串函数
上文所说到,redis的sds遵循c字符串的规范,最后一个存储空字符串。这样使得sds也可使用<string.h>库的部分函数
1.2.6总结
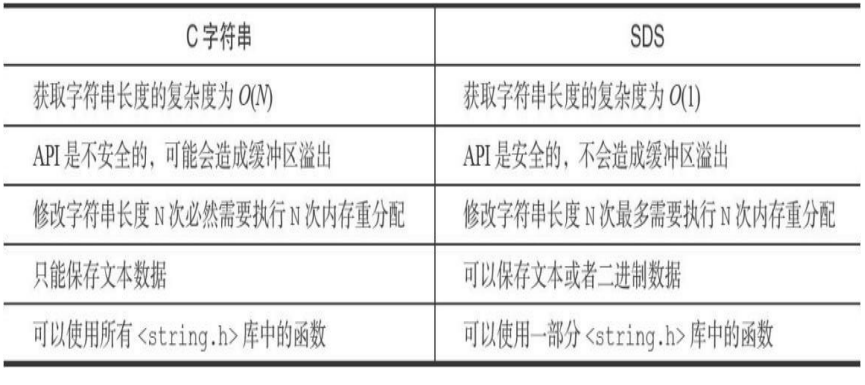
1.2重点
Redis只会使用C字符串作为字面量,在大多数情况下,Redis使用 SDS(Simple Dynamic String,简单动态字符串)作为字符串表示。 ·比起C字符串,SDS具有以下优点:
1)常数复杂度获取字符串长度。
2)杜绝缓冲区溢出。
3)减少修改字符串长度时所需的内存重分配次数。
4)二进制安全。
5)兼容部分C字符串函数。
2.链表
由于C并没有内置链表这样的数据结构,所以redis构建了自己的链表实现。
链表在Redis中的应用非常广泛,比如列表键的底层实现之一就是链表。当一个列表键包含了数量比较多的元素,又或者列表中包含的元素都是比较长的字符串时,Redis就会使用链表作为列表键的底层实现。
除了链表键之外,发布与订阅、慢查询、监视器等功能也用到了链 表,Redis服务器本身还使用链表来保存多个客户端的状态信息,以及 使用链表来构建客户端输出缓冲区(output buffer),本书后续的章节 将陆续对这些链表应用进行介绍。
2.1链表和链表节点的实现
链表节点实现:
typedef struct listNode {
// 前置节点 struct listNode * prev;
// 后置节点 struct listNode * next;
// 节点的值 void * value; }
listNode;
链表实现:
list结构为链表提供了表头指针head、表尾指针tail,以及链表长度 计数器len,而dup、free和match成员则是用于实现多态链表所需的类型 特定函数: ·dup函数用于复制链表节点所保存的值;
·free函数用于释放链表节点所保存的值;
·match函数则用于对比链表节点所保存的值和另一个输入值是否相 等。
typedef struct list { // 表头节点 listNode * head;
// 表尾节点 listNode * tail;
// 链表所包含的节点数量 unsigned long len;
// 节点值复制函数 void *(*dup)(void *ptr);
// 节点值释放函数 void (*free)(void *ptr);
// 节点值对比函数 int (*match)(void *ptr,void *key); } list;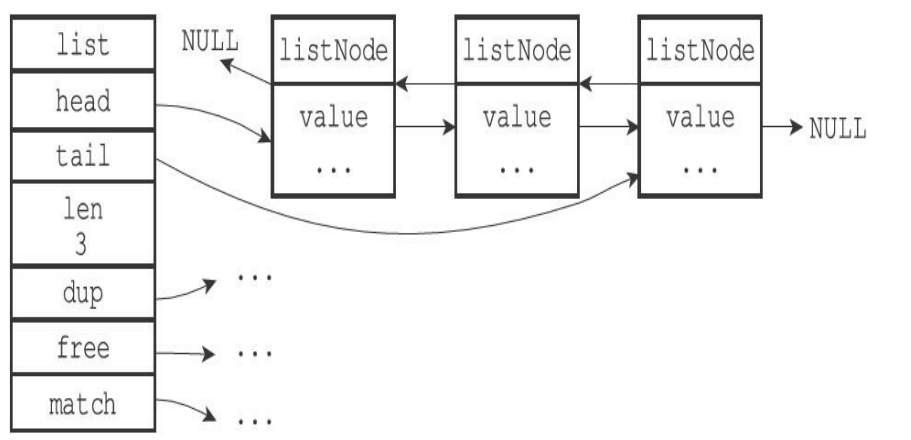
redis的链表特点:
·双端:链表节点带有prev和next指针,获取某个节点的前置节点和 后置节点的复杂度都是O(1)。
·无环:表头节点的prev指针和表尾节点的next指针都指向NULL, 对链表的访问以NULL为终点。
·带表头指针和表尾指针:通过list结构的head指针和tail指针,程序 获取链表的表头节点和表尾节点的复杂度为O(1)。 ·带链表长度计数器:程序使用list结构的len属性来对list持有的链表节点进行计数,程序获取链表中节点数量的复杂度为O(1)。
·多态:链表节点使用void*指针来保存节点值,并且可以通过list结构的dup、free、match三个属性为节点值设置类型特定函数,所以链表可以用于保存各种不同类型的值。
2.2重点
·链表被广泛用于实现Redis的各种功能,比如列表键、发布与订阅、慢查询、监视器等。
·每个链表节点由一个listNode结构来表示,每个节点都有一个指向 前置节点和后置节点的指针,所以Redis的链表实现是双端链表。
·每个链表使用一个list结构来表示,这个结构带有表头节点指针、 表尾节点指针,以及链表长度等信息。
·因为链表表头节点的前置节点和表尾节点的后置节点都指向 NULL,所以Redis的链表实现是无环链表。
·通过为链表设置不同的类型特定函数,Redis的链表可以用于保存 各种不同类型的值。
3.字典
redis的字典实现上跟Java中的hashmap非常相似,如果你对Java的hashmap实现有所了解,本节可以简单阅读跳过。不过渐进式hash可以看看
字典,又称为符号表(symbol table)、关联数组(associative array)或映射(map),是一种用于保存键值对(key-value pair)的抽 象数据结构。形如java中的hashmap。
当执行SET msg "Hello world"命令时,在数据库中创建一个键为"msg",值为"hello world"的键值对时,这 个键值对就是保存在代表数据库的字典里面的。
3.1字典的实现
3.1.1哈希表实现
typedef struct dictht {
// 哈希表数组
dictEntry **table;
// 哈希表大小
unsigned long size;
// 哈希表大小掩码,用于计算索引值
// 总是等于size-1
unsigned long sizemask;
// 该哈希表已有节点的数量
unsigned long used; } dictht;
table是一个数组,数组中的每个元素都是一个指向 dict.h/dictEntry结构的指针,每个dictEntry结构保存着一个键值对。
size 属性记录了哈希表的大小,也即是table数组的大小
used属性则记录 了哈希表目前已有节点(键值对)的数量
sizemask属性的值总是等于 size-1,这个属性和哈希值一起决定一个键应该被放到table数组的哪个索引上面。
3.1.2字典节点实现
typedef struct dictEntry {
// 键
void *key;
// 值
union{ void *val; uint64_tu64; int64_ts64; } v;
// 指向下个哈希表节点,形成链表
struct dictEntry *next; } dictEntry;
key属性保存着键值对中的键
v属性则保存着键值对中的值,
其中键值对的值可以是一个指针,或者是一个uint64_t整数,又或者是一 个int64_t整数。
next属性是指向另一个哈希表节点的指针,这个指针可以将多个哈 希值相同的键值对连接在一次,以此来解决键冲突(collision)的问题。
3.1.3字典
typedef struct dict {
// 类型特定函数
dictType *type;
// 私有数据
void *privdata;
// 哈希表
dictht ht[2];
// rehash 索引
// 当rehash 不在进行时,值为-1
in trehashidx; /* rehashing not in progress if rehashidx == -1 */ } dict;
type属性和privdata属性是针对不同类型的键值对,为创建多态字典 而设置的:
·type属性是一个指向dictType结构的指针,每个dictType结构保存了 一簇用于操作特定类型键值对的函数,Redis会为用途不同的字典设置 不同的类型特定函数。
而privdata属性则保存了需要传给那些类型特定函数的可选参数。
    typedef struct dictType {
    // 计算哈希值的函数
    unsigned int (*hashFunction)(const void *key);
    // 复制键的函数
    void *(*keyDup)(void *privdata, const void *key);
    // 复制值的函数
    void *(*valDup)(void *privdata, const void *obj);
    // 对比键的函数
    int (*keyCompare)(void *privdata, const void *key1, const void *key2);
    // 销毁键的函数
    void (*keyDestructor)(void *privdata, void *key);
    // 销毁值的函数
    void (*valDestructor)(void *privdata, void *obj); } dictType;
ht属性是一个包含两个项的数组,数组中的每个项都是一个dictht哈 希表,一般情况下,字典只使用ht[0]哈希表,ht[1]哈希表只会在对ht[0] 哈希表进行rehash时使用。
除了ht[1]之外,另一个和rehash有关的属性就是rehashidx,它记录 了rehash目前的进度,如果目前没有在进行rehash,那么它的值为-1。
3.2解决哈希冲突
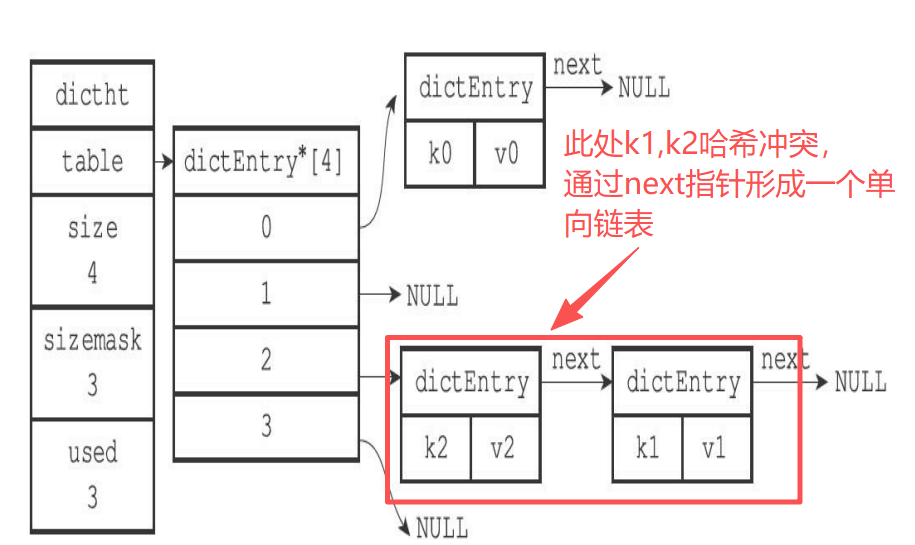
Redis的哈希表使用链地址法(separate chaining)来解决键冲突,即拉链法, 每个哈希表节点都有一个next指针,多个哈希表节点可以用next指针构 成一个单向链表,被分配到同一个索引上的多个节点可以用这个单向链 表连接起来,这就解决了键冲突的问题。
3.3rehash
哈希表保存的键值对会逐渐地增多或者减 少,为了让哈希表的负载因子(load factor)维持在一个合理的范围之 内,当哈希表保存的键值对数量太多或者太少时,程序需要对哈希表的 大小进行相应的扩展或者收缩。
1)为字典的ht[1]哈希表分配空间,这个哈希表的空间大小取决于 要执行的操作,以及ht[0]当前包含的键值对数量(也即是ht[0].used属性 的值):
·如果执行的是扩展操作,那么ht[1]的大小为第一个大于等于 ht[0].used*2的2 n(2的n次方幂);
·如果执行的是收缩操作,那么ht[1]的大小为第一个大于等于 ht[0].used的2 n。
2)将保存在ht[0]中的所有键值对rehash到ht[1]上面:rehash指的是 重新计算键的哈希值和索引值,然后将键值对放置到ht[1]哈希表的指定 位置上。
3)当ht[0]包含的所有键值对都迁移到了ht[1]之后(ht[0]变为空 表),释放ht[0],将ht[1]设置为ht[0],并在ht[1]新创建一个空白哈希 表,为下一次rehash做准备。
哈希表的扩展与收缩
负载因子计算公式:
负载因子= 哈希表已保存节点数量/ 哈希表大小
load_factor = ht[0].used / ht[0].size
当以下条件中的任意一个被满足时,程序会自动开始对哈希表执行扩展操作:
1)服务器目前没有在执行BGSAVE命令或者BGREWRITEAOF命 令,并且哈希表的负载因子大于等于1。
2)服务器目前正在执行BGSAVE命令或者BGREWRITEAOF命 令,并且哈希表的负载因子大于等于5。
因为在执行BGSAVE命令 或BGREWRITEAOF命令的过程中,Redis需要创建当前服务器进程的子进程,而大多数操作系统都采用写时复制(copy-on-write)技术来优化子进程的使用效率,所以在子进程存在期间,服务器会提高执行扩展操作所需的负载因子,从而尽可能地避免在子进程存在期间进行哈希表扩 展操作,这可以避免不必要的内存写入操作,最大限度地节约内存。
哈希收缩条件:当哈希表的负载因子小于0.1时,程序自动开始对哈希 表执行收缩操作。
3.4渐进式hash
rehash动作并不是一次性、集中式地完成 的,而是分多次、渐进式地完成的。如果四百万、四千万甚至四亿个键值对,那 么要一次性将这些键值对全部rehash,庞大的计算量可能导致redis宕机或者停止服务。
redis渐进式hash主要思想是分而治之,具体做法如下:
1.首先在ht[1]上分配空间,让字典同时又ht[0]和ht[1]两个哈希表,
2.在字典中维持一个索引计数器变量rehashidx初始化为0表rehash开始,
3.在rehash期间每次对字典执行添加、删除、查找或者更新操作时,程序除了执行指定的操作以外,还会顺带将ht[0]哈希表在 rehashidx索引上的所有键值对rehash到ht[1],当rehash工作完成之后,程 序将rehashidx属性的值+1。
4.随着字典操作的不断执行,最终在某个时间点上,ht[0]的所有 键值对都会被rehash至ht[1],这时程序将rehashidx属性的值设为-1,表 示rehash操作已完成。
rehash过程中字典的删除(delete)、查找 (find)、更新(update)等操作会在两个哈希表上进行,而新增元素则只会落在ht[1]哈希表上。查找操作会有限查找ht[0]
3.5重点
·Redis中的字典使用哈希表作为底层实现,每个字典带有两个哈希表,一个平时使用,另一个仅在进行rehash时使用。
·当字典被用作数据库的底层实现,或者哈希键的底层实现时, Redis使用MurmurHash2算法来计算键的哈希值。
·哈希表使用链地址法来解决键冲突,被分配到同一个索引上的多 个键值对会连接成一个单向链表。
·在对哈希表进行扩展或者收缩操作时,程序需要将现有哈希表包 含的所有键值对rehash到新哈希表里面,并且这个rehash过程并不是一 次性地完成的,而是渐进式地完成的。
4.跳跃表(重点)
跳表个人认为算是redis在数据结构里面非常值得学习和独特的,这个可以重点看看。
跳表(skiplist)是有序的数据结构,支持平均O(logN)、最坏O(N)复杂度的节点查找。通过在每个节点中维持多个指向其他节点的指针,从而达到快速访问节点的目的。
Redis使用跳跃表作为有序集合键的底层实现之一,如果一个有序集合包含的元素数量比较多,又或者有序集合中元素的成员 (member)是比较长的字符串时,Redis就会使用跳跃表来作为有序集合键的底层实现。
举例:
redis> ZRANGE fruit-price 0 2 WITHSCORES
1)"banana"
2)"5"
3)"cherry"
4)"6.5"
5)"apple"
6)"8"
redis> ZCARD fruit-price (integer)130
frut-price有序集合的数据都保存在一个跳表里面,其中跳表节点存储一个水果的价格,所有价格按从低到高排序。
即跳表顺序应该是:
“banana”: 5 -> "cherry":6.5 -> "apple" :8
跳表在redis中只在两种场景下使用一个是实现有序集合键,另一个是在集群节点中用作内部数据结构。
4.1跳表基础认识
首先,普通单链表来说,即使链表是有序的,我们要查找某个元素,也需要从头到尾遍历整个链表。这样效率很低,时间复杂度是O(n)。
所以为了优化查询效率,可以尝试为链表创建“索引“
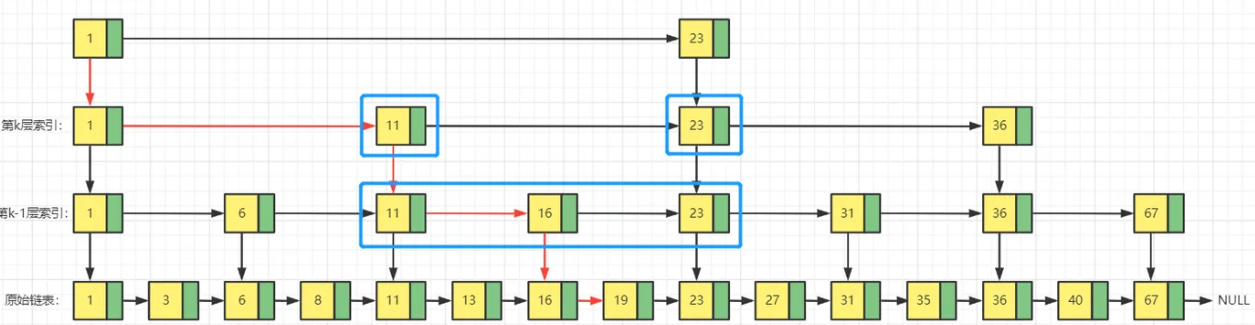
假如我们要查询值为19的节点,我们从索引层开始遍历,当遍历到16时,下个节点的值为23,所以,19一定在这两个节点之间。我们通过16节点的down指针来到原始链表,将继续遍历,直到找到值为19的节点。
在没有建“索引”之前,我们需要遍历8次,才能找到19,而在建立“索引”后,需要6次就能找到。
跳表就是基于这种建立索引的方式来进行查询效率的优化,但跳表肯定不止一层索引。
跳表时间复杂度的计算:
假设链表有n个节点,每两个节点生成一个索引,则有第一层索引节点的个数为n/2,第二层索引节点的个数是第一层个数的一半n/4,以此类推,第h层节点的个数就是n/(2^h)。假设,第h层有两个节点,则:h = log2n - 1,再算上原始链表,则整个跳表的高度就是log2n。
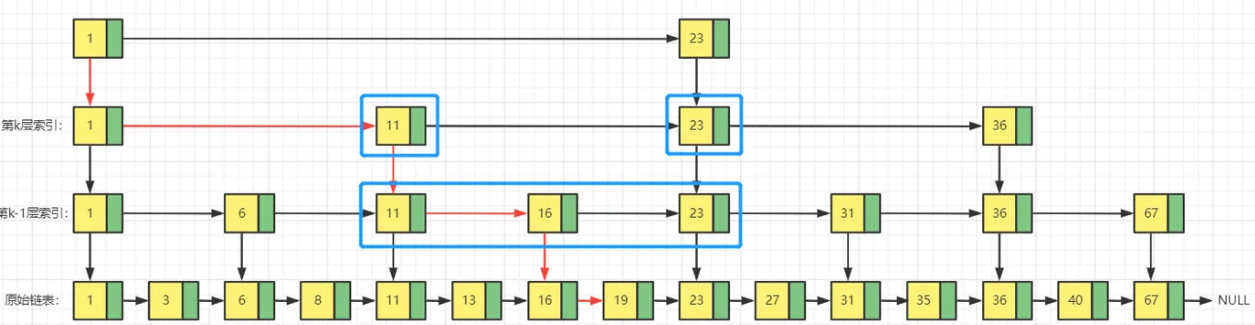
假设我们查找的还是19,在第k层索引中,当我们遍历到11时,发现19在11和23之间,我们通过11的down节点,来到第k-1层。在第k-1层索引中,11 到 23 最多包含3个节点(包含11 和 23 的节点),所以在第k-1索引,我们最多需要遍历3个节点,依次类推,每一层索引都最多只需要遍历3个节点。
通过上面的分析,我们知道了m = 3,也就是说在跳表中查询任意节点的时间复杂度是O(3*log2n),去掉常数项后,时间复杂度就是:O(log2n)。这个查找跟二分查找的时间复杂度一样。换句话说,我们是基于单链表实现了二分查找,神奇吧。但是,这种查询效率的提升是有代价的,也就是我们需要维护多层级索引,才能实现。这也是一种空间换时间的思路。
空间复杂度:
假设原始链表有n个节点,按照每连个节点上升一个索引节点的索引结构,第一层有n/2,第二层n/4,依次类推,第h层有n/2^h个索引节点。假设第h层有2个节点。则总共有:
n/2 + n/4 + n/8 + … + 2 = n-2。所以,跳表的空间复杂度是O(n)。
跳表的插入和删除
我们想在跳表中插入和删除一个节点,第一步是要找到插入和删除的位置,然后再执行插入或者删除,因为跳表的查询时间复杂度是O(log2n),插入和删除的时间复杂度也是O(log2n)。
4.1.2跳表索引的动态更新
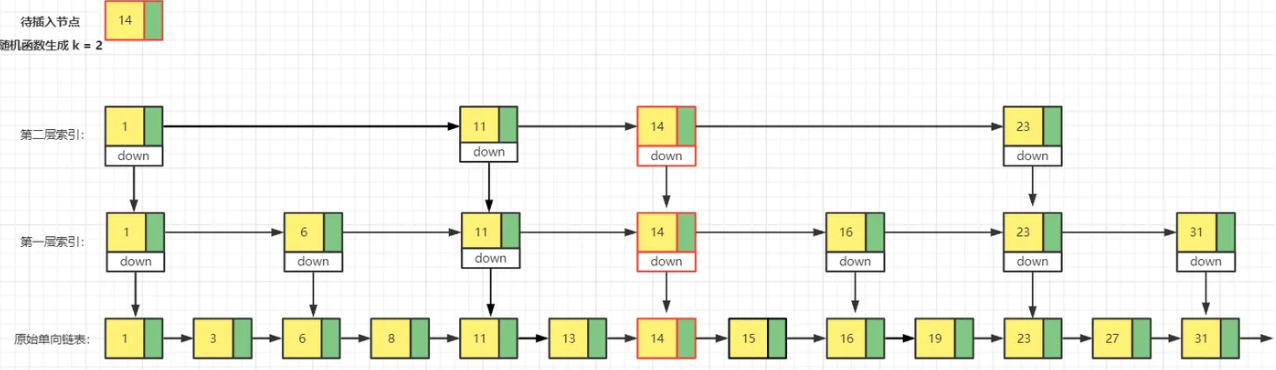
当我们一直往跳表中添加元素,如果不更新索引就可能出现,某2个索引之间的索引数过多,极端情况下,会退化为单向链表。
作为一种动态数据结构,我们需要某种手段作为索引节点和原始链表大小的平衡,也就是说,当链表中的节点数增多时,也响应的增加一些索引节点,避免复杂度的退化。红黑树和AVL树是通过左旋和右旋来维持左右子树的平衡。跳表则是通过随机函数来维护这种平衡。
4.2redis实现的跳表
Redis的跳跃表由redis.h/zskiplistNode和redis.h/zskiplist两个结构定 义,其中zskiplistNode结构用于表示跳跃表节点,而zskiplist结构则用于 保存跳跃表节点的相关信息,比如节点的数量,以及指向表头节点和表 尾节点的指针等等。
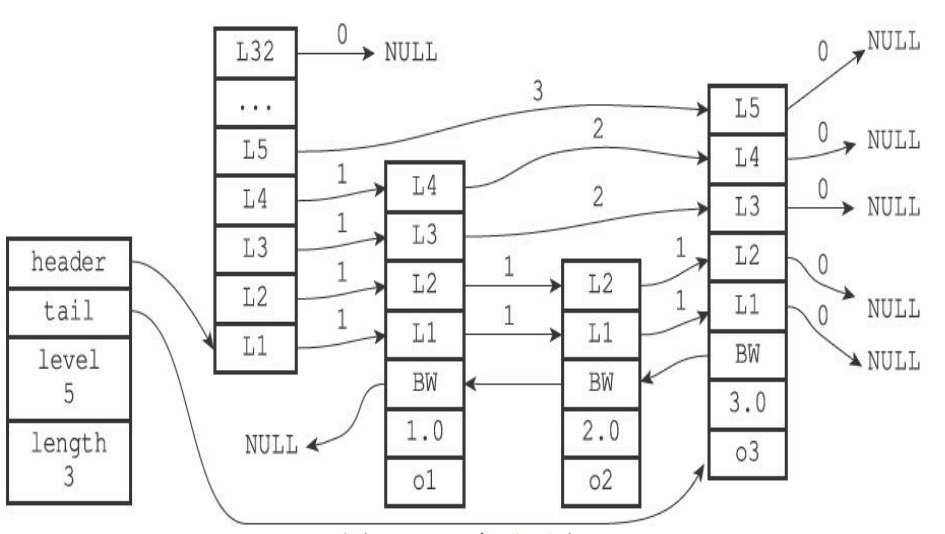
header指向跳跃表的表头节点
tail指向跳表的尾节点
level记录当前跳表层数最大的那层的节点数,即最上面的节点数
length:记录跳跃表的长度,
4.2.2跳表节点
typedef struct zskiplistNode {
// 层
struct zskiplistLevel {
// 前进指针
struct zskiplistNode *forward;
// 跨度
unsigned int span; }
level[];
// 后退指针
struct zskiplistNode *backward;
// 分值
double score;
// 成员对象
robj *obj; } zskiplistNode;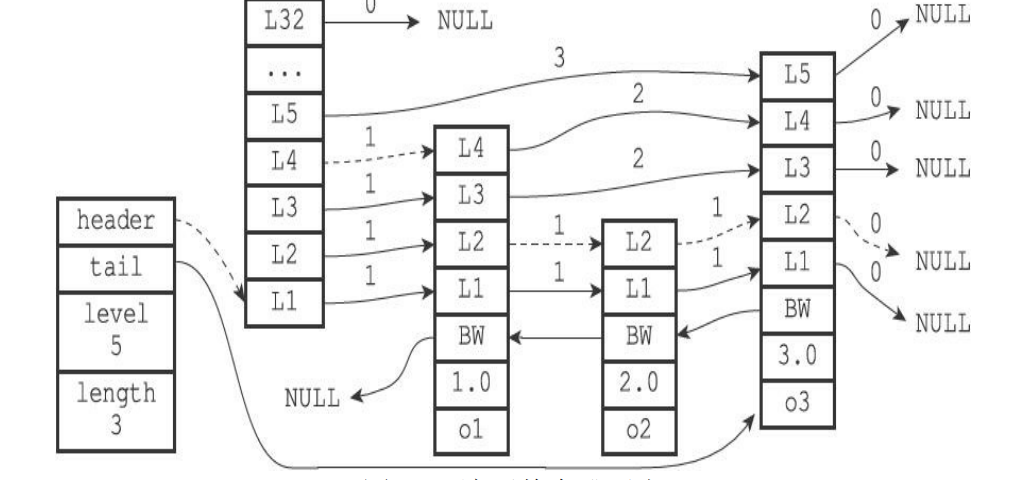
1.层
每次创建一个新跳跃表节点的时候,程序都根据幂次定律(power law,越大的数出现的概率越小)随机生成一个介于1和32之间的值作为 level数组的大小,这个大小就是层的“高度”。
2.前进指针
每个层都有一个指向表尾方向的前进指针,用于从表头向表尾方向访问节点
3.层的跨度
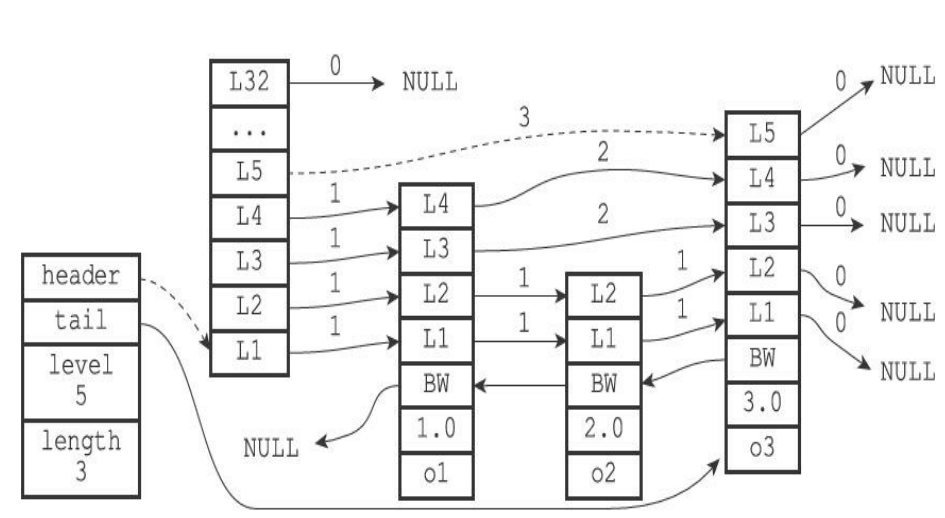
层的跨度(level[i].span属性)用于记录两个节点之间的距离:
两个节点之间的跨度越大,它们相距得就越远。 ·指向NULL的所有前进指针的跨度都为0,因为它们没有连向任何节点。
跨度实际上是用来计算排 位(rank)的:在查找某个节点的过程中,将沿途访问过的所有层的跨度累计起来,得到的结果就是目标节点在跳跃表中的排位。
举例:
用虚线标记了在跳跃表中查找分值为3.0、成员对 象为o3的节点时,沿途经历的层:查找的过程只经过了一个层,并且层 的跨度为3,所以目标节点在跳跃表中的排位为3。
4.后退指针
节点的后退指针(backward属性)用于从表尾向表头方向访问节 点:跟可以一次跳过多个节点的前进指针不同,因为每个节点只有一个 后退指针,所以每次只能后退至前一个节点。
5.分值和成员
节点的分值(score属性)是一个double类型的浮点数,跳跃表中的 所有节点都按分值从小到大来排序。
节点的成员对象(obj属性)是一个指针,它指向一个字符串对 象,而字符串对象则保存着一个SDS值。
在同一个跳跃表中,各个节点保存的成员对象必须是唯一的,但是多个节点保存的分值却可以是相同的:分值相同的节点将按照成员对象在字典序中的大小来进行排序,成员对象较小的节点会排在前面,而成员对象较大的节点则会排在后面)。
4.2.3跳跃表
仅靠上文的跳表节点其实就可以组成一个跳表,但是redis直接提供了跳跃表的结构实现,通过使用一个zskiplist结构来持有这些节点,程序可以更方便地 对整个跳跃表进行处理,比如快速访问跳跃表的表头节点和表尾节点, 或者快速地获取跳跃表节点的数量(也即是跳跃表的长度等信息
typedef struct zskiplist {
// 表头节点和表尾节点
structz skiplistNode *header, *tail;
/ 表中节点的数量
unsigned long length;
// 表中层数最大的节点的层数
int level; } zskiplist;
4.3重点回顾
跳表实现查询效率提高主要使用索引层来实现。
跳跃表是有序集合的底层实现之一。
·Redis的跳跃表实现由zskiplist和zskiplistNode两个结构组成,其中 zskiplist用于保存跳跃表信息(比如表头节点、表尾节点、长度),而 zskiplistNode则用于表示跳跃表节点。
·每个跳跃表节点的层高都是1至32之间的随机数。
·在同一个跳跃表中,多个节点可以包含相同的分值,但每个节点 的成员对象必须是唯一的。 ·跳跃表中的节点按照分值
5.整数集合
整数集合(intset)是集合键的底层实现之一,当一个集合只包含整 数值元素,并且这个集合的元素数量不多时,Redis就会使用整数集合 作为集合键的底层实现。
5.1整数集合实现
整数集合(intset)是Redis用于保存整数值的集合抽象数据结构, 它可以保存类型为int16_t、int32_t或者int64_t的整数值,并且保证集合 中不会出现重复元素。
这个集合的实现没什么特别要说的,跟普通认知里面的集合实现几乎一直,有一个数组,length属性。
比较特别的是他有 encoding这个属性来决定编码方式。
虽然intset结构将contents属性声明为int8_t类型的数组,但实际上 contents数组并不保存任何int8_t类型的值,contents数组的真正类型取决 于encoding属性的值:
·INTSET_ENC_INT16,那么 一个int16_t类型的数组,数组里的每个项都是一个int16_t类型的整数值 (最小值为-32768,最大值为32767)。
·NTSET_ENC_INT32,一个int32_t类型的数组,数组里的每个项都是一个int32_t类型的整数值 (最小值为-2147483648,最大值为2147483647)。
·INTSET_ENC_INT64, 一个int64_t类型的数组,数组里的每个项都是一个int64_t类型的整数值 (最小为-9223372036854775808,最大值为 9223372036854775807)。
升级
每当我们要将一个新元素添加到整数集合里面,并且新元素的类型 比整数集合现有所有元素的类型都要长时,整数集合需要先进行升级 (upgrade),然后才能将新元素添加到整数集合里面。
1)根据新元素的类型,扩展整数集合底层数组的空间大小,并为 新元素分配空间。
2)将底层数组现有的所有元素都转换成与新元素相同的类型,并 将类型转换后的元素放置到正确的位上,而且在放置元素的过程中,需 要继续维持底层数组的有序性质不变。
3)将新元素添加到底层数组里面。
整数集合的升级策略有两个好处,一个是提升整数集合的灵活性, 另一个是尽可能地节约内存。
要让一个数组可以同时保存int16_t、int32_t、int64_t三种类 型的值,最简单的做法就是直接使用int64_t类型的数组作为整数集合的 底层实现。但是这样会造成空间上的浪费。
整数集合不支持降级操作,一旦对数组进行了升级,编码就会一直保持升级后的状态。
5.2重点
整数集合是集合键的底层实现之一。
·整数集合的底层实现为数组,这个数组以有序、无重复的方式保 存集合元素,在有需要时,程序会根据新添加元素的类型,改变这个数 组的类型。
·升级操作为整数集合带来了操作上的灵活性,并且尽可能地节约 了内存。
·整数集合只支持升级操作,不支持降级操作。
6.压缩列表
压缩列表(ziplist)是列表键和哈希键的底层实现之一
redis一般在列表键只包含少量列表项,且列表项是小整数或者是比较短的字符串,就会使用ziplist。
现在新版本会用qicklist而不是ziplist了,他是ziplist和linkedlist的混合体,这章主要讲解ziplist
例如,执行以下命令将创建一个压缩列表实现的列表键:
redis> RPUSH lst 1 3 5 10086 "hello" "world"
(integer)6
redis> OBJECT ENCODING lst
"ziplist"
6.1压缩列表的构成
压缩列表是Redis为了节约内存而开发的,是由一系列特殊编码的 连续内存块组成的顺序型(sequential)数据结构。一个压缩列表可以包 含任意多个节点(entry),每个节点可以保存一个字节数组或者一个整数值。

zlbytes:记录整个压缩列表的内存大小,在内存重新分配或者重新计算zlend的位置使用
zltail:记录尾节点距离压缩列表起始地址有几个字节,通过这个偏移量,程序可以快速定位列表尾节点的位置
zllen:记录列表的节点数量,当zllen < 65535时,zllen就是压缩列表的节点数量,当值等于 65535 则需要遍历整个列表才能算出
entryX: 压缩列表包含的各个节点,节点长度有节点保存的内容决定
zlend:特殊值0xFF(255)用于标记压缩列表末端
6.2压缩列表节点构成
每个压缩列表节点可以保存一个字节数组或者一个整数值,其中字节数组有三种大小可选:·长度小于等于63(2 6–1)字节的字节数组; ·长度小于等于16383(2 14–1)字节的字节数组; ·长度小于等于4294967295(2 32–1)字节的字节数组;
整数则可选六种大小:·4位长,介于0至12之间的无符号整数; ·1字节长的有符号整数; ·3字节长的有符号整数; ·int16_t类型整数; ·int32_t类型整数; ·int64_t类型整数。
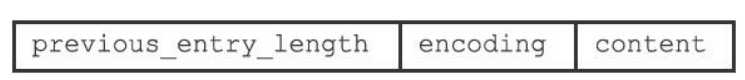
每个压缩列表节点都由previous_entry_length、encoding、content三个部分组成
previous_entry_length
节点的previous_entry_length属性以字节为单位,记录了压缩列表中前一个节点的长度。程序可以通过指针运算,根据当前节点的起始地址来计算出前一个节点的起始地址。
这个属性的值时变化的,他根据前一个节点长度变化大小。
如果前一节点的长度小于254字节,那么previous_entry_length属性 的长度为1字节:前一节点的长度就保存在这一个字节里面。 · 如果前一节点的长度大于等于254字节,那么previous_entry_length 属性的长度为5字节:其中属性的第一字节会被设置为0xFE(十进制值 254),而之后的四个字节则用于保存前一节点的长度。
压缩列表的从表尾向表头遍历操作就是使用这一原理实现的,只要我们拥有了一个指向某个节点起始地址的指针,那么通过这个指针以及 这个节点的previous_entry_length属性,程序就可以一直向前一个节点回 溯,最终到达压缩列表的表头节点。
encoding
节点的encoding属性记录了节点的content属性所保存数据的类型以 及长度:
·一字节、两字节或者五字节长,值的最高位为00、01或者10的是字节数组编码:这种编码表示节点的content属性保存着字节数组,数组的长度由编码除去最高两位之后的其他位记录; ·
一字节长,值的最高位以11开头的是整数编码:这种编码表示节 点的content属性保存着整数值,整数值的类型和长度由编码除去最高两 位之后的其他位记录;
content
节点的content属性负责保存节点的值,节点值可以是一个字节数组 或者整数,值的类型和长度由节点的encoding属性决定。
6.3连锁更新
前面说过,每个节点的previous_entry_length属性都记录了前一个节 点的长度:
·如果前一节点的长度小于254字节,那么previous_entry_length属性 需要用1字节长的空间来保存这个长度值。
·如果前一节点的长度大于等于254字节,那么previous_entry_length 属性需要用5字节长的空间来保存这个长度值。
现在,考虑这样一种情况:在一个压缩列表中,有多个连续的、长 度介于250字节到253字节之间的节点e1至eN

因为e1至eN的所有节点的长度都小于254字节,e1至eN 的所有节点的previous_entry_length属性都是1字节长的。
这时,如果我们将一个长度大于等于254字节的新节点new设置为压 缩列表的表头节点,那么new将成为e1的前置节点
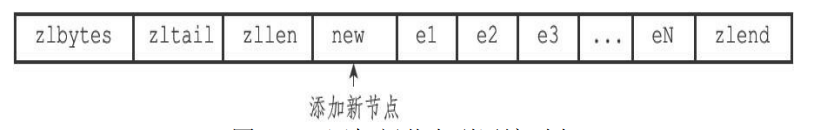
因为e1的previous_entry_length属性仅长1字节,它没办法保存新节 点new的长度,所以程序将对压缩列表执行空间重分配操作,并将e1节 点的previous_entry_length属性从原来的1字节长扩展为5字节长。
现在,麻烦的事情来了,e1原本的长度介于250字节至253字节之 间,在为previous_entry_length属性新增四个字节的空间之后,e1的长度 就变成了介于254字节至257字节之间,而这种长度使用1字节长的 previous_entry_length属性是没办法保存的。
因此,为了让e2的previous_entry_length属性可以记录下e1的长度, 程序需要再次对压缩列表执行空间重分配操作,并将e2节点的 previous_entry_length属性从原来的1字节长扩展为5字节长。
正如扩展e1引发了对e2的扩展一样,扩展e2也会引发对e3的扩展, 而扩展e3又会引发对e4的扩展……为了让每个节点的 previous_entry_length属性都符合压缩列表对节点的要求,程序需要不断 地对压缩列表执行空间重分配操作,直到eN为止。
Redis将这种在特殊情况下产生的连续多次空间扩展操作称之为“连 锁更新”(cascade update),除了添加新节点可能会引发连锁更新之外,删除节点也可能会引发 连锁更新。
因为连锁更新在最坏情况下需要对压缩列表执行N次空间重分配操作,而每次空间重分配的最坏复杂度为O(N),所以连锁更新的最坏 复杂度为O(N 2)。
尽管连锁更新的复杂度较高,但它真正造成性能问题 的几率是很低的:
·首先,压缩列表里要恰好有多个连续的、长度介于250字节至253 字节之间的节点,连锁更新才有可能被引发,在实际中,这种情况并不 多见;
·其次,即使出现连锁更新,但只要被更新的节点数量不多,就不 会对性能造成任何影响:比如说,对三五个节点进行连锁更新是绝对不 会影响性能的;
因为以上原因,ziplistPush等命令的平均复杂度仅为O(N),在实 际中,我们可以放心地使用这些函数,而不必担心连锁更新会影响压缩 列表的性能。
6.5重点
·压缩列表是一种为节约内存而开发的顺序型数据结构。
·压缩列表被用作列表键和哈希键的底层实现之一。
·压缩列表可以包含多个节点,每个节点可以保存一个字节数组或 者整数值。
·添加新节点到压缩列表,或者从压缩列表中删除节点,可能会引 发连锁更新操作,