
Python FastApi
快速上手,定义spring中的controller来接受http请求
from fastapi import FastAPI
app = FastAPI()
@app.get("/")
async def root():
    return {"message": "Hello World"}
ser(user: User):
    return user
1.路由
相当于Spring中的@RequestMapping,@Getmaping注解,用法也相同,使用的是装饰器可以理解为注解
app = FastAPI()@app.get("/")
async def root():
return {"message": "Hello World"}
@app.get("/hello/{name}")
async def say_hello(name: str):
return {"message": f"Hello {name}"}
注:fastapi自带swagger,http://127.0.0.1:8000/docs路径为docs,很爽不像spring还要自己配(doge)
请求的参数可以通过以下方式设置,相当于@Requestparam,
@app.get("/hello")
async def say_hello(skip : int = Query(0, ge=0, le=100),limit: int = Query(10, ge=0, le=100)):
    return {"skip": skip, "limit": limit}
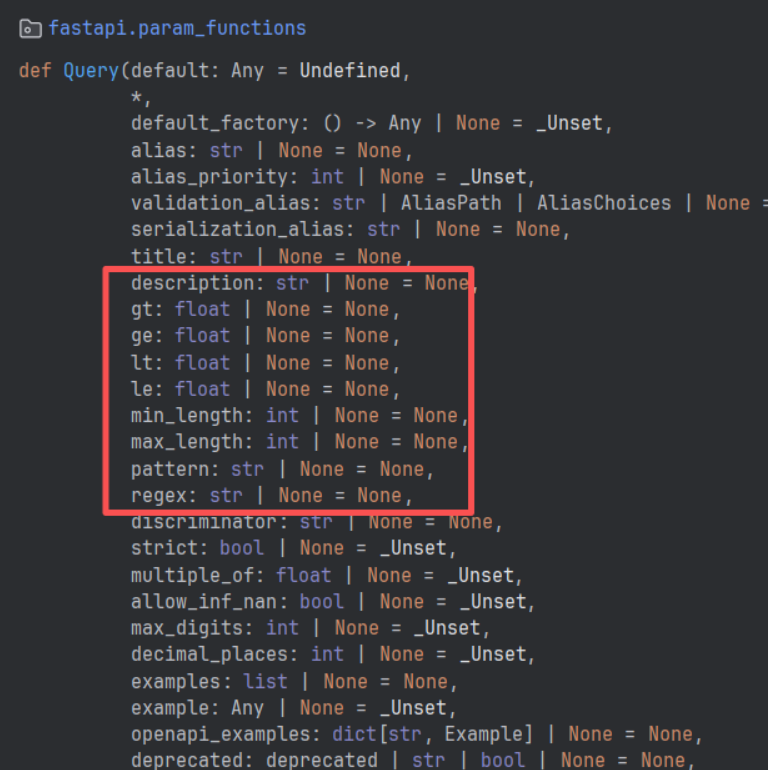
Query是对参数进行校验的作用,指定参数的类型,ge,le等进行数值校验,常用的为红框内的属性
对于接口参数接受转为对象操作:
1.先定义对应的类:一定要继承BaseModel类
class User(BaseModel):
    username: str
    password: str
2.在方法形参直接使用即可
@app.post("/user")
async def create_user(user: User):
    return user
2.响应类型设置
默认情况下,FastAPI会自动将路径操作函数返回的Python 对象(字典、列表、Pydantic 模型等),经由jsonable_encoder 转换为JSON兼容格式,并包装为JSONResponse返回。这省去了手动序列化的步骤,让开发者能更专注于业务逻辑。如果需要返回非 JSON数据(如HTML、文件流),FastAPI提供了丰富的响应类型来返回不同数据
以下是fastapi支持的不同响应类型:
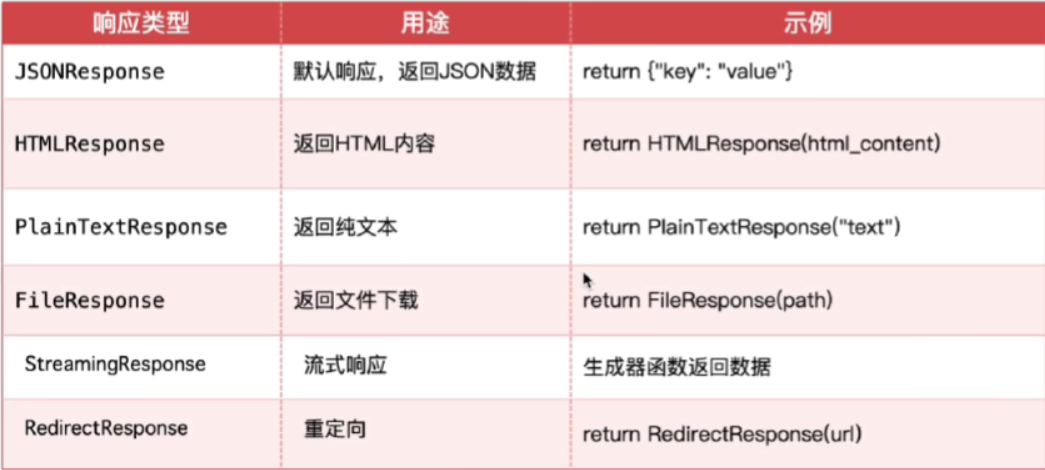
默认响应json,当我们需要指定响应类型时。可以在装饰器上声明接口的响应类型
html响应:
@app.get("/html",response_class=HTMLResponse)
async def get_html():
    return "<h1>html<h1>"
文件类型响应:
@app.get("/file")
async def get_file():
    file_path = "./file/ScreenShot_2026-05-12_142942_388.png"
    return FileResponse(file_path)
自定义响应:
response_model 是路径操作装饰器(如 @app.get或@app.post)的关键参数,它通过一个Pydantic模型来严格定义和约束APl 端点的输出格式。这一机制在提供自动数据验证和序列化的同时,更是保障数据安全性的第一道防线。
一旦返回的数据中缺少或者多了属性,就会抛出异常
首先我们定义一个类,让这个类继承BaseModel
class News(BaseModel):
    title: str
    content: str
然后在装饰器上将类名配置进去:
@app.get("/news",response_model=News)
async def get_news():
    return {
        "title": "king是EXO曾经的C位",
        "content": "被资本雪藏"
}异常处理:
使用HTTPException进行异常抛出
@app.get('/news/{id}')
async def get_news(id: int):
    id_list = [1, 2, 3, 4, 5, 6]
    if id not in id_list:
        raise HTTPException(status_code=404, detail="当前id不存在")
    return {"id":id}
效果:

3.中间件
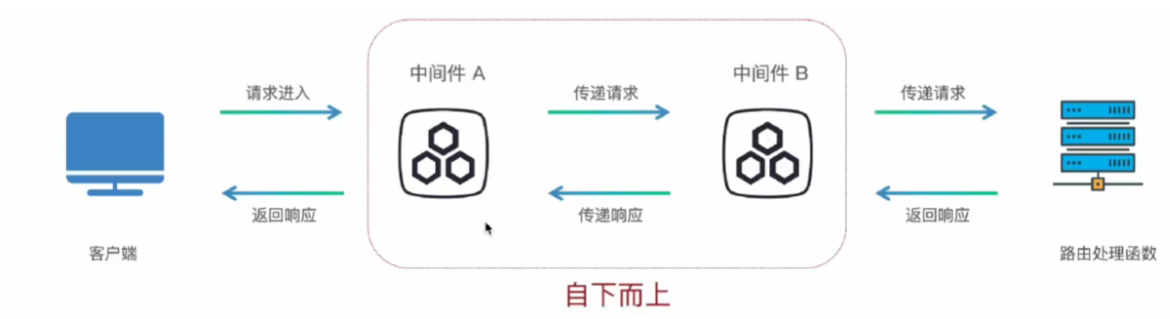
中间件(Middleware)是一个在每次请求进入FastAPI 应用时都会被执行的函数。可以理解为spring中的拦截器 它在请求到达实际的路径操作(路由处理函数)之前运行,并且在响应返回给客户端之前再运行一次。
可以在中间件做登录校验,白名单,黑名单校验等等,
写法:
主要使用@app.middleware()装饰器,在对应方法上装饰即可
实例:
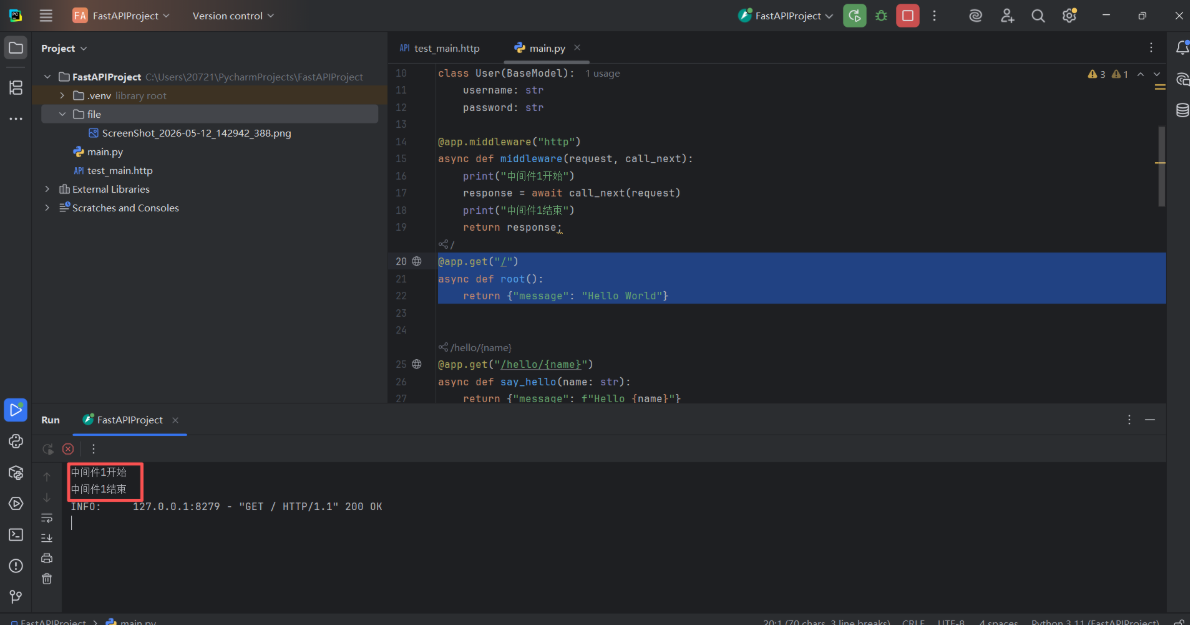
@app.middleware("http")
async def middleware(request, call_next):
    print("中间件1开始")
    response = await call_next(request)  //如名字所示,进行下一个处理
    print("中间件1结束")
    return response;
@app.get("/")
async def root():
return {"message": "Hello World"}效果:
执行顺序是自下而上的,现在定义两个中间件:
先执行middleware2,middleware2使用call_next调用middleware1,中间件1执行结束返回,中间件2执行结束。
@app.middleware("http")
async def middleware1(request, call_next):
    print("中间件1开始")
    response = await call_next(request)
    print("中间件1结束")
    return response;

@app.middleware("http")
async def middleware2(request, call_next):
    print("中间件2开始")
    response = await call_next(request)
    print("中间件2结束")
    return response;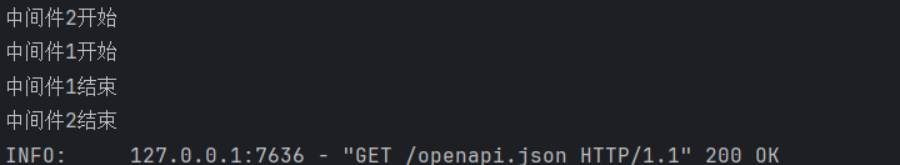
4.依赖注入
使用依赖注入系统来共享通用逻辑,减少代码重复
依赖项:可重用的组件(函数/类),负责提供某种功能或数据。 注入:FastAPI自动帮你调用依赖项,并将结果"注入"到路径操作函数中。
优点:
代码复用:一次编写,多处使用
解耦:业务逻辑与基础设施代码分离
易于测试:轻松地用模拟依赖替换真实依赖进行测试
例如:权限认证,共享数据库连接,共享业务逻辑,处理请求参数都可以使用依赖注入
使用方法:
1.创建依赖项 -> 2. 导入dependcy -> 3.声明依赖项
此处以接口请求参数设置为例:
1.创建要执行的公共逻辑,设置分页参数
async def common_parameters(skip: int = Query(0, ge=0),limit: int = Query(10, le=60)):
    return {"skip": skip,"limit":limit}
2.导入依赖
from fastapi import Depends3.声明依赖项,形如Depends(依赖项)
@app.get("/news/news_list")
async def get_news_list(
 commons = Depends(common_parameters)
):
    return commons;
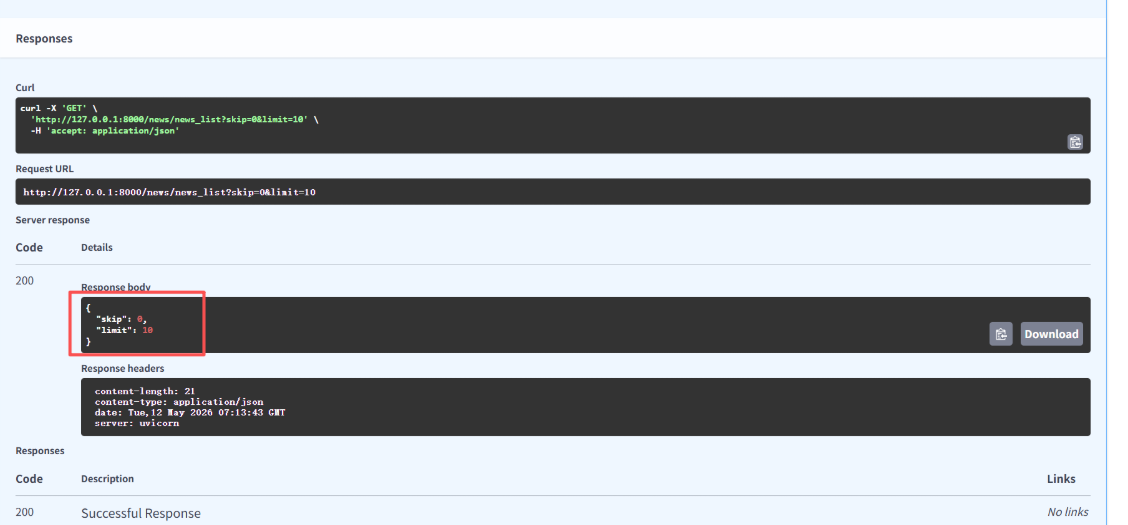
效果,接口返回了依赖项方法中的返回值:
5.ORM工具
安装:
python常用的orm有:SQLAlchemy ORM,Django ORM,Tortoise ORM
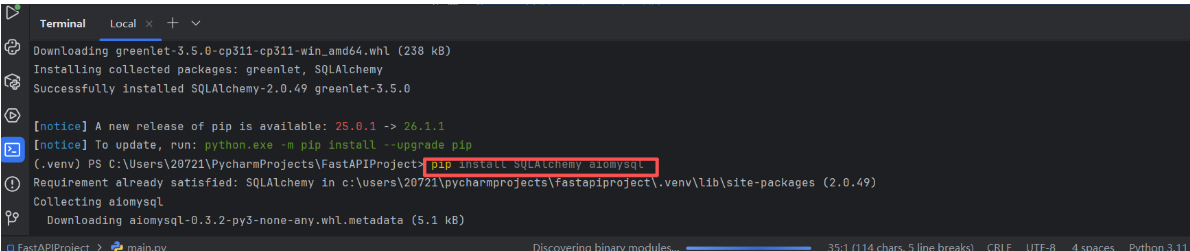
本文以SQLAlchemy为例,首先安装orm
在控制台输入pip intall sqlalchemy aiomysql进行安装
SQLAlchemy 建表
1.配置数据库引擎:
from sqlalchemy.ext.asyncio import create_async_engine

ASYNCABLE_DATABASE_URL= "mysql+aiomysql://root:123456@localhost:3306/fast_api"

async_engine = create_async_engine(
ASYNCABLE_DATABASE_URL,
echo=True,
pool_size = 10,
max_overflow = 20,)
2.创建模型类:
# 定义基类
class Base(DeclarativeBase):
    create_time : Mapped[datetime] = mapped_column(DateTime,insert_default=func.now(),default=func.now(),comment="创建时间")
    update_time : Mapped[datetime] = mapped_column(DateTime,insert_default=func.now(),default=func.now(), onupdate=func.now(), comment="修改时间")

class Book(Base):
    __tablename__ = "book"

    id : Mapped[int] = mapped_column(primary_key=True,comment="书籍id")
    book_name : Mapped[str] = mapped_column(String(255),comment="书名")
    author : Mapped[str] = mapped_column(String(255),comment="作者")
    price : Mapped[float] = mapped_column(Float,comment="书籍价格")
3.定义建表方法
# 建表
async def create_table():
    async with async_engine.connect() as conn:
        await conn.run_sync(Base.metadata.create_all) #基类元数据创建
最后调用一下即可,这里使用startup在项目启动后调用,(注意startup方法被废弃了存在资源泄露问题):
@app.on_event("startup")
async def startup():
    await create_table()
控制台日志输出:
2026-05-12 15:41:44,474 INFO sqlalchemy.engine.Engine SELECT DATABASE() 2026-05-12 15:41:44,474 INFO sqlalchemy.engine.Engine [raw sql] () 2026-05-12 15:41:44,478 INFO sqlalchemy.engine.Engine SELECT @@sql_mode 2026-05-12 15:41:44,478 INFO sqlalchemy.engine.Engine [raw sql] () 2026-05-12 15:41:44,479 INFO sqlalchemy.engine.Engine SELECT @@lower_case_table_names 2026-05-12 15:41:44,479 INFO sqlalchemy.engine.Engine [raw sql] () 2026-05-12 15:41:44,479 INFO sqlalchemy.engine.Engine BEGIN (implicit) 2026-05-12 15:41:44,479 INFO sqlalchemy.engine.Engine DESCRIBE fast_api.book 2026-05-12 15:41:44,479 INFO sqlalchemy.engine.Engine [raw sql] () 2026-05-12 15:41:44,516 INFO sqlalchemy.engine.Engine CREATE TABLE book ( id INTEGER NOT NULL COMMENT '书籍id' AUTO_INCREMENT, book_name VARCHAR(255) NOT NULL COMMENT '书名', author VARCHAR(255) NOT NULL COMMENT '作者', price FLOAT NOT NULL COMMENT '书籍价格', create_time DATETIME NOT NULL COMMENT '创建时间', update_time DATETIME NOT NULL COMMENT '修改时间', PRIMARY KEY (id) )
路由匹配中使用ORM
核心:创建依赖项,使用Depends注入到处理函数中,通过依赖项来创建数据库会话
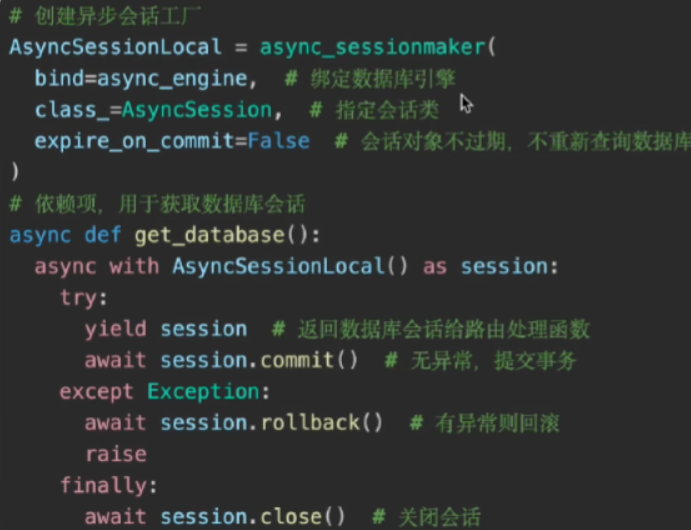
我们通过上一节已经创建了数据库引擎,在这里可以直接使用
先声明sqlsession创建的依赖项:
async def get_db():
    async with AsyncSqlSessionLocal() as session:
        try:
            yield session #返回数据库会话
            await session.commit()
        except Exception:
            await session.rollback()
            raise
        finally:
            await session.close()
然后我们就可以通过Depend来获取sqlsession
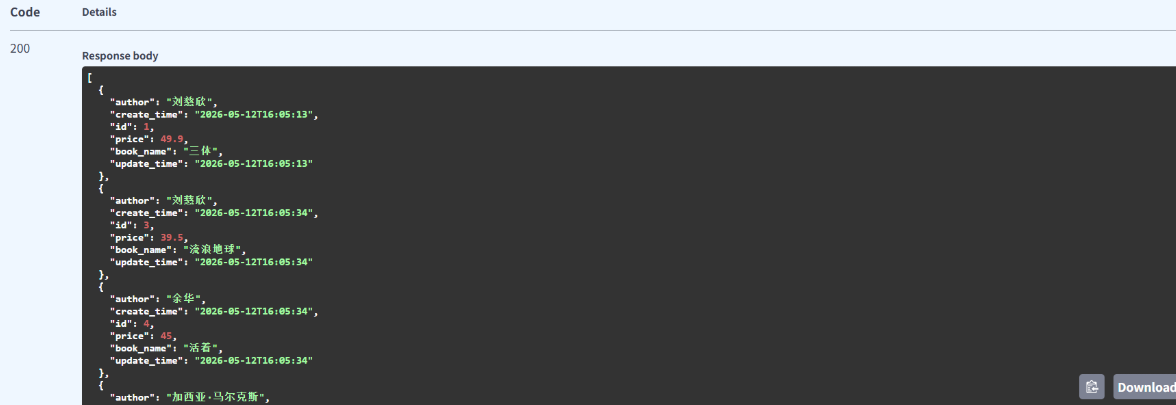
@app.get("/book")
async def book(db: AsyncSession = Depends(get_db)):
    result = await db.execute(select(Book))
    return result.scalars().all()
result.scalars().all()获取全部记录
result.scalars.first()获取第一条
result.scalars.get("主键")根据主键获取
效果:
SQLAlchemy查询
基本查询
根据上节了解到基本查询的方法
select(“类名”)
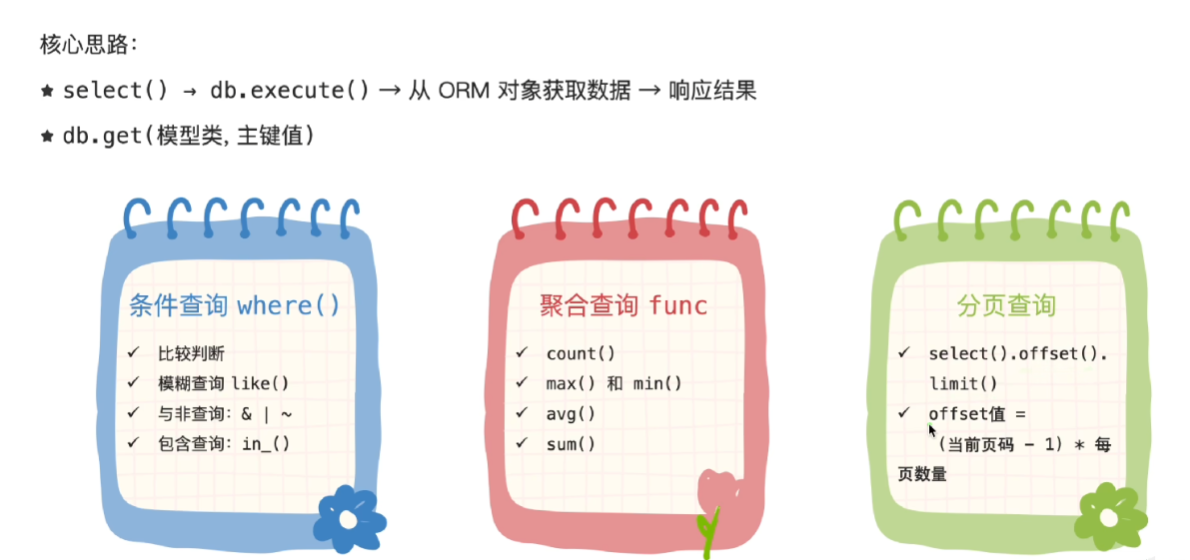
要加上where条件非常简单,仅需再调用where方法然后将条件传入即可,如下
select(Book).where(条件1,条件2...)
对于比较简单的where条件,如只通过一个值来查询可以使用get方法
book = await db.get(Book,book_id)按照id查询,示例:
此处scalar_one_or_none()方法如名所示,要么只有一条要么为空,当有多条时会报错。
@app.get("/book/{book_id}")
async def book_by_id(book_id : int,db: AsyncSession = Depends(get_db)):
    result = await db.execute(select(Book).where(Book.id == book_id))
    book = result.scalar_one_or_none();
    return book;
使用模糊查询like(),示例:
@app.get("/book")
async def book(db: AsyncSession = Depends(get_db)):
    result = await db.execute(select(Book).where(Book.author.like('刘%')))
    book = result.scalars().all()
    return book
对于与或非操作示例:
在两个条件之间添加对应符号即可
@app.get("/book")
async def book(db: AsyncSession = Depends(get_db)):
    result = await db.execute(select(Book).where((Book.author.like('刘%')) | (Book.price > 50)))
    book = result.scalars().all()
    return book
聚合查询(count,avg,max,min,sum等)
聚合计算使用func.方法名(类.属性)
示例:
@app.get("/book/count")
async def get_count(db: AsyncSession = Depends(get_db)):
    result = await db.execute(select(func.count(Book.id)))
    ## result = await db.execute(select(func.max(Book.price)))
    # result = await db.execute(select(func.sum(Book.price)))
    # result = await db.execute(select(func.avg(Book.price)))
    count = result.scalar()
    return count
分页查询
select().offset().limit() offset:跳过的记录数
limit:返回的记录数
offset = (当前页面 - 1) * 每页数量(limit)
示例:
@app.get("/book/page")
async def page_book(
        page: int = Query(default=1),
        page_size:int = Query(default=10,ge=0,le=10),
        db: AsyncSession = Depends(get_db)):
    skip = (page - 1) * page_size
    stmt = select(Book).offset(skip).limit(page_size)
    result = await db.execute(stmt)
    books = result.scalars().all()
    return books
更优雅的写法,用依赖注入对分页参数做处理:
class PaginationParams(BaseModel):
    page: int = Query(1, ge=1)
    page_size: int = Query(10, ge=1, le=100)

    @property
    def offset(self) -> int:
        return (self.page - 1) * self.page_size

    @property
    def limit(self) -> int:
        return self.page_size
@app.get("/book/page")
async def page_book(
        pagination: PaginationParams = Depends(),db: AsyncSession = Depends(get_db)):
    stmt = select(Book).offset(pagination.offset).limit(pagination.limit)
    result = await db.execute(stmt)
    books = result.scalars().all()
    return books
查询总结
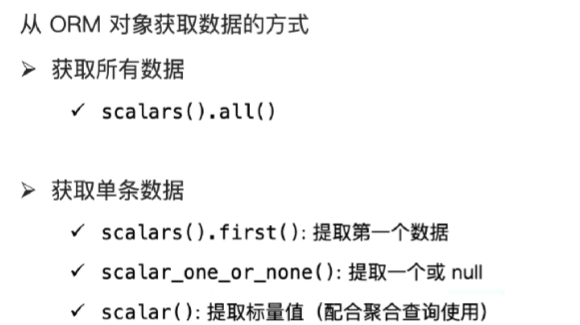
插入操作
核心步骤:定义ORM对象
添加对象到事务:add(对象)
commit提交到数据库
示例:
定义请求体对应类:
class BookRequest(BaseModel):
    book_name: str
    author: str
    price: float
插入代码:
@app.post("/book/add_book",response_model=BookRequest)
async def add_book(book: BookRequest,db: AsyncSession = Depends(get_db)):
    #获取book参数,创建图书对象(_dict__ 返回 book对象的属性字典) 其实就是dto转成po
    book_obj = Book(**book.__dict__)
    db.add(book_obj)
    await db.commit()
    return book
更新
核心步骤:查询 -> 属性赋值 -> commit
代码示例:
@app.post("/book/update_book/{book_id}")
async def add_book(book_id: int,book_request: BookRequest,db: AsyncSession = Depends(get_db)):
    book = await db.get(Book,book_id)
    if book is None:
        raise HTTPException(status_code=404, detail="图书不存在")

    book.book_name = book_request.book_name
    book.author = book_request.author
    book.price = book_request.price
    await db.commit()
    return book
删除
核心步骤:查询 ->delete删除 -> commit
@app.delete("/book/update_book/{book_id}")
async def add_book(book_id: int,db: AsyncSession = Depends(get_db)):
    #获取book参数,创建图书对象(_dict__ 返回 book对象的属性字典)
    book = await db.get(Book,book_id)
    if book is None:
        raise HTTPException(status_code=404, detail="图书不存在")
    await db.delete(book)
    await db.commit()
    return book
项目实战
工程结构划分
config负责配置,crud跟mapper对应,models存放实体类,routers为controller
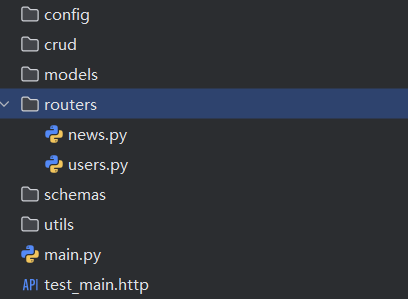
模块化路由
对于路由即controller进行模块化,功能划分,不能全丢在一块,划分完之后在main.py里面挂在对应模块即可
来看news路由,这里的prefix就跟spring中在controller类上使用@RequestMapping()注解一样,对于这个文件下所有接口添加这个prefix的前缀,同时创建APIRouter实例之后在自带的swagg文档里面对应分类,分类名称用tags配置。
创建完router实例之后,后续装饰器用@router(叫什么用什么)
from fastapi import APIRouter
#创建APIRouter实例
router = APIRouter(prefix="/api/news", tags=["news"])

@router.get("/categories")
async def get_news_categories():
    return {"msg": "success"}
挂在到main.py中
#挂载路由
app.include_router(news.router)
数据库连接设置.
在这里封装数据库引擎,数据库会话方法,后续在router通过依赖注入,使用get_db方法来获取数据库会话
from sqlalchemy.ext.asyncio import create_async_engine, async_sessionmaker, AsyncSession

ASYNCABLE_DATABASE_URL= "mysql+aiomysql://root:123456@localhost:3306/news_app"

async_engine = create_async_engine(
ASYNCABLE_DATABASE_URL,
echo=True,
pool_size = 10,
max_overflow = 20,)

AsyncSqlSessionLocal = async_sessionmaker(
    bind = async_engine,#绑定数据库引擎
    class_=AsyncSession,# 指定会话类
    expire_on_commit = False #不让会话提交就过期
)
async def get_db():
    async with AsyncSqlSessionLocal() as session:
        try:
            yield session #返回数据库会话
            await session.commit()
        except Exception:
            await session.rollback()
            raise
        finally:
            await session.close()
跨域问题
通过在main.py添加中间件解决跨域问题
app.add_middleware(
    CORSMiddleware,
    allow_origins=["*"],  #允许的源
    allow_credentials=True, #允许的cookie
    allow_methods=["*"], #允许的方法
    allow_headers=["*"], #允许的请求头
)
分页类封装
对page_size和limit进行基础处理,后续需要分页查询参数,通过依赖注入PaginationParams即可
from pydantic import BaseModel
from fastapi import Query

class PaginationParams(BaseModel):
    page: int = Query(1, ge=1)
    page_size: int = Query(10, ge=1, le=100)

    @property
    def offset(self) -> int:
        return (self.page - 1) * self.page_size

    @property
    def limit(self) -> int:
        return self.page_size
分类查询实现
路由:
@router.get("/categories")
async def get_news_categories(pagination: PaginationParams = Depends() ,db : AsyncSession = Depends(get_db)):
    categories = await news.get_news_categories(db, pagination.page, pagination.page_size)
    return {"code": 200,
            "message": "查询分类成功",
            "data": categories}
crud:
async def get_news_categories(db: AsyncSession,skip: int = 0, limit: int = 100):

    stmt = select(Category).offset(skip).limit(limit)
    result = await db.execute(stmt)
    return result.scalars().all()
统一响应结果封装
def success_response(message : str = "success",data = None):
    content = {
        "code" : 200,
        "message" : message,
        "data" : data
    }
    return JSONResponse(content=jsonable_encoder(content))
新闻模块实现
models实体类:
import datetime


from sqlalchemy import Column, String, func, DateTime, Integer
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, foreign

from models.base import Base


class Category(Base):
    __tablename__ = "news_category"

    id : Mapped[int] = mapped_column(primary_key=True,autoincrement=True,comment="分类id")
    name : Mapped[str] = mapped_column(String(50),unique=True,nullable=False, comment="分类名称")
    sort_order : Mapped[int] = mapped_column(Integer,default=0,nullable=False, comment="排序")

    def __repr__(self):
        return f"<Category id={Category.id} name={self.name} sort_order={self.sort_order}>"

class News(Base):
    __tablename__ = "news"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True, comment="分类id")
    title: Mapped[str] = mapped_column(String(255), nullable=False, comment="新闻标题")
    description: Mapped[str] = mapped_column(String(500), comment="新闻描述")
    content: Mapped[str] = mapped_column(String,nullable=False, comment="新闻内容")
    image: Mapped[str] = mapped_column(String(255),nullable=False, comment="图片路径")
    author: Mapped[str] = mapped_column(String(50),nullable=False, comment="作者")
    category_id: Mapped[int] = mapped_column(Integer,nullable=False, comment="分类id")
    views: Mapped[int] = mapped_column(Integer, comment="浏览量")
    publish_time : Mapped[datetime] = mapped_column(DateTime,insert_default=func.now(),default=func.now(),comment="发布时间")
    def __repr__(self):
        return f"<News id={News.id} title={self.title} description={self.description} content={News.content}>"
按分类查询新闻:
# 新闻列表查询接口(按分类)
@router.get("/list")
async def list_news(
        categoryId: int,  # 必填的分类ID(路径或查询参数)
        pagination: PaginationParams = Depends(),  # 分页参数
        db: AsyncSession = Depends(get_db)  # 数据库会话
):
    # 获取当前页的新闻数据(根据分类ID和分页参数)
    news_info = await news_curd.get_news(db, categoryId, pagination.page, pagination.page_size)

    # 获取该分类下的新闻总数(用于计算是否有更多页)
    total = await news_curd.get_news_count(db, categoryId)

    # 判断是否还有更多数据:当前页码的数据量 + 已加载数据 < 总记录数
    has_more = (pagination.page + len(news_info) < total)

    return {
        "code": 200,
        "message": "新闻查询成功",
        "data": {
            "list": news_info,  # 当前页新闻列表
            "total": total,  # 总记录数
            "hasMore": has_more  # 是否还有下一页
        }
    }
crud:
async def get_news(db: AsyncSession, category_id: int, skip: int = 1, limit: int = 100):
    stmt = select(News).where(News.category_id == category_id).offset(skip).limit(limit)
    result = await db.execute(stmt)
    return result.scalars().all()
async def get_news_count(db: AsyncSession, category_id: int):
stmt = select(func.count(News.id)).where(News.category_id == category_id)
result = await db.execute(stmt)
return result.scalar_one()新闻详情查询实现:
路由:
# 新闻详情查询接口
@router.get("/detail")
async def get_news_detail(
        news_id: int = Query(..., alias="id"),  # 查询参数名为 "id",映射到变量 news_id(必填)
        db: AsyncSession = Depends(get_db)  # 数据库会话
):
    # 根据新闻ID查询详细信息
    news_detail = await news_curd.get_news_detail(db, news_id)

    # 若新闻不存在,抛出 404 异常
    if not news_detail:
        raise HTTPException(status_code=404, detail="新闻不存在")

    # 更新该新闻的浏览量(异步执行,不影响主返回)
    await news_curd.update_news_views(db, news_id)

    # 查询相关新闻(基于相同分类,排除当前新闻)
    related_news = await news_curd.get_related_news(db, news_detail.category_id, news_detail.id)

    # 组装并返回详情数据(字段映射为前端友好的格式)
    return {
        "code": 200,
        "message": "新闻详情查询成功",
        "data": {
            "id": news_detail.id,
            "title": news_detail.title,
            "content": news_detail.content,
            "image": news_detail.image,
            "author": news_detail.author,
            "publishTime": news_detail.publish_time,  # 原模型字段 publish_time 映射为 publishTime
            "categoryId": news_detail.category_id,  # 映射为 categoryId
            "views": news_detail.views,
            "relatedNews": related_news  # 相关新闻列表
        }
    }
curd:
async def get_news_detail(db: AsyncSession, newsId : int):
    stmt = select(News).where(News.id == newsId)
    result = await db.execute(stmt)
    return result.scalar_one_or_none()
async def update_news_views(db: AsyncSession, news_id: int):
stmt = update(News).where(News.id == news_id).values(views = News.views + 1)
await db.execute(stmt)
await db.commit()async def get_related_news(db: AsyncSession, category_id: int, news_id: int, limit: int = 5):
stmt = (select(News).where(
News.category_id == category_id,
News.id != news_id,
).order_by(News.views.desc(),
News.publish_time.desc()).limit(limit))
result = await db.execute(stmt)
related_news = result.scalars().all()
return related_news